(Auszug aus der Pressemitteilung)

Kommentar von Pranay Ahlawat, Chief Technology and AI Officer bei Commvault
Zwei Ausfälle innerhalb von 48 Stunden haben vergangene Woche weltweit die Arbeit sowie den Reiseverkehr in den gesamten USA lahmgelegt. Keiner der Ausfälle war ein Angriff, beide waren selbstverschuldet. Wenn Routineänderungen Microsoft 365 oder den amerikanischen Luftraum in derselben Woche in die Knie zwingen können, sollte man sich fragen, was böswillige Täter anrichten könnten. Resilienz ist spätestens jetzt kein Notfallplan mehr. Sie ist ein Mandat für das C-Level.
Ausfälle sind Alltag. ThousandEyes verzeichnete Anfang 2026 weltweit 200 bis 400 Netzwerkausfälle pro Woche, ohne dass jemand sie bemerkte. Gewohnheitsausfälle, scheinen zwar seltener zu werden: Das Uptime Institute weist seit fünf Jahren in Folge sinkende Ausfallraten pro Standort aus. Die großen folgenschweren Ausfälle werden dagegen häufiger.
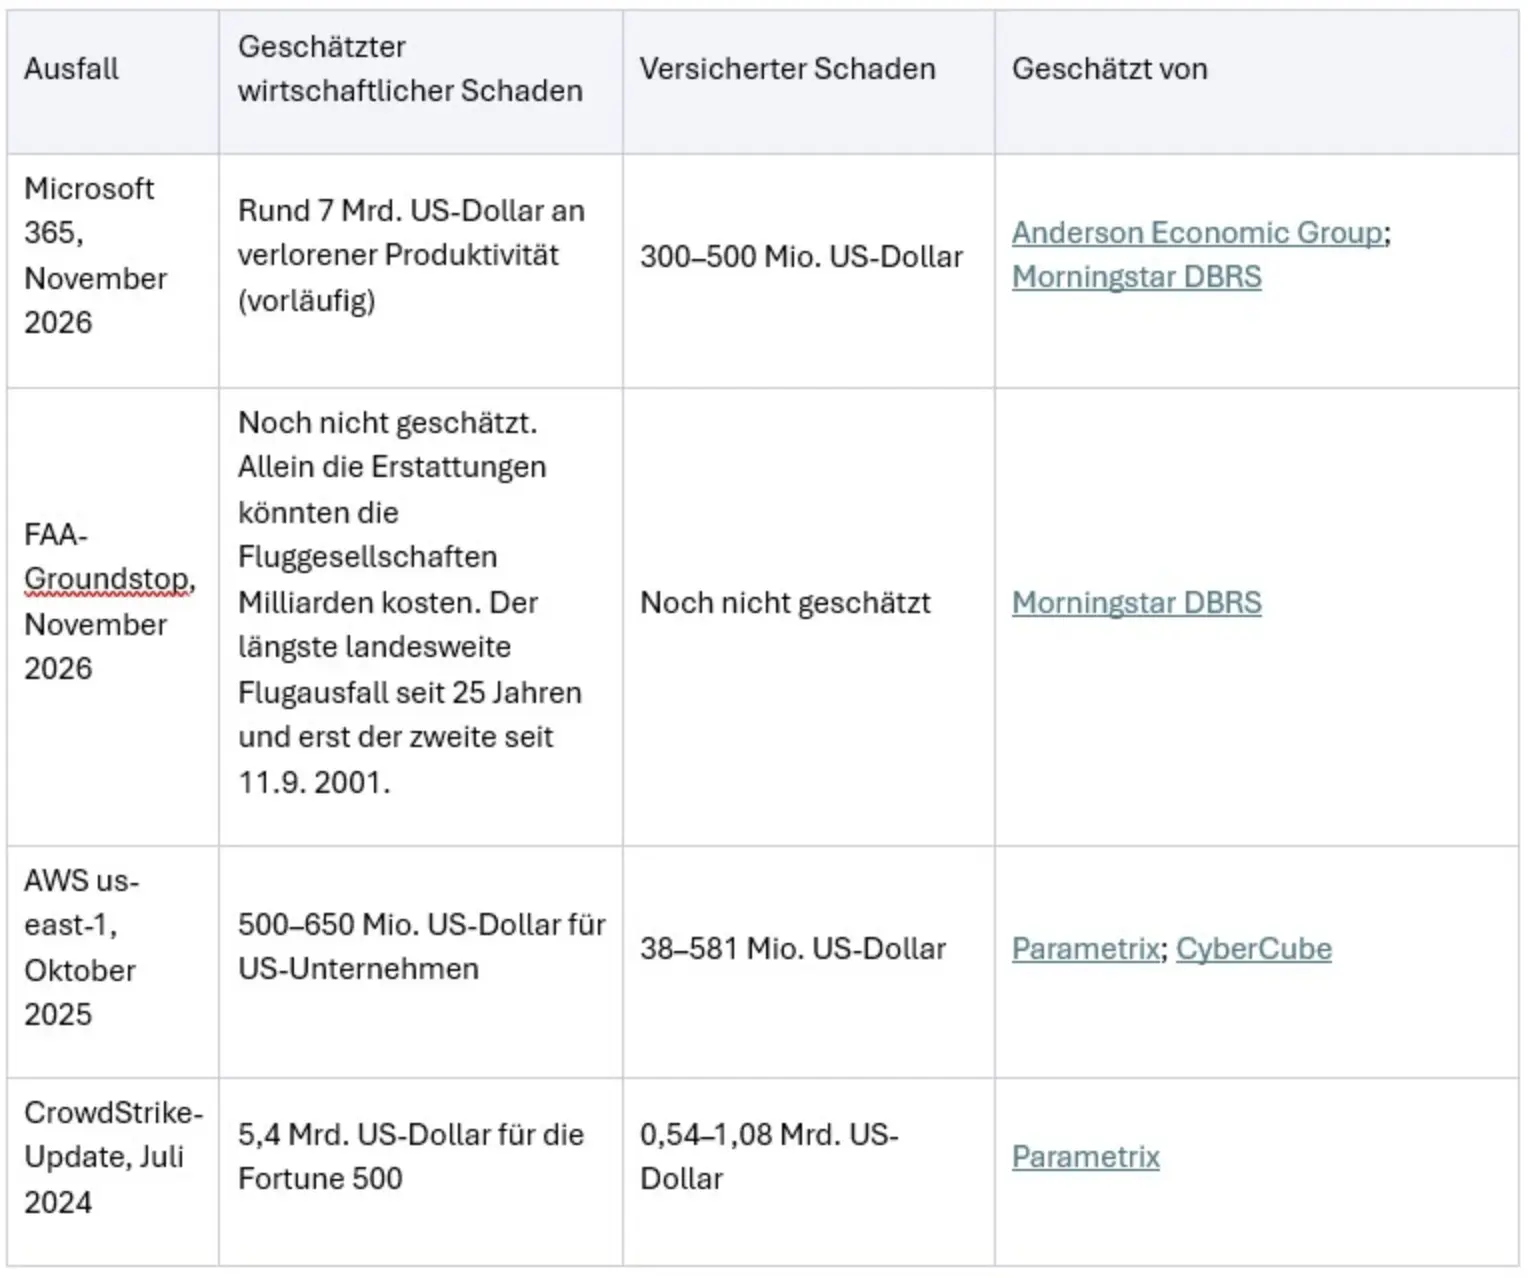
Kritische Ausfälle bei den drei größten Cloud-Anbietern stiegen zwischen 2022 und 2024 um 52 Prozent, die Zahl der verlorenen Stunden nahmen um 51 Prozent auf 221 pro Jahr zu. Zwar war 2025 stabiler, 2026 aber mit drei Microsoft-365-Ausfällen, einem landesweiten Groundstop bei noch sechs Wochen Jahresrestzeit dagegen alles andere als beruhigend.
Nichtverfügbarkeit wird zudem teuer. Ein schlechter Tag kostete früher Millionen. Das fehlerhafte Update von CrowdStrike im Juli 2024 kostete die Fortune 500 schätzungsweise 5,4 Milliarden US-Dollar. Über die Global 2000 hinweg beziffern Splunk und Oxford Economics die jährlichen Kosten von Ausfallzeiten 2024 auf 400 Milliarden US-Dollar, rund 9 Prozent der Gewinne. Der Microsoft-Ausfall von Freitag, dem 13.11.2026, könnte allein an verlorener Produktivität sieben Milliarden US-Dollar kosten. Versicherungen übernehmen nur einen Bruchteil der Schäden. Nach dem CrowdStrike-Vorfall deckten die Policen schätzungsweise 10 – 20 Prozent der Verluste der Fortune 500.
Folgenschwere Ausfälle werden immer häufiger. Dafür gibt es drei Gründe:
- Anbieterkonzentration: AWS, Microsoft und Google halten 61 Prozent des Cloud-Marktes mit einem Gesamtvolumen von 168 Milliarden US-Dollar pro Quartal. Drittanbieter sind für rund zwei Drittel der öffentlich gemeldeten Ausfälle der vergangenen neun Jahre verantwortlich. Ausfälle eines Players ziehen auch andere Anbieter nach.
- Hochleistungen: Die Ausfälle begannen mit absichtlichen Änderungen: ein Netzwerk-Upgrade bei Microsoft, neue Ausrüstung bei der FAA. Laut Uptime Institute sind Fehler bei Konfiguration und Change-Management die häufigste Ursache. Die IT verändert komplexe Systeme schneller, Effekte von Änderungen sind schwerer zu verstehen.
- KI als neues Risiko: Die Cloud-Ausgaben stiegen im vergangenen Quartal um 55 Prozent und KI macht inzwischen etwa ein Drittel davon aus. Ein Ergebnis ist mehr Last auf derselben gemeinsam genutzten Infrastruktur. Zudem handelt es sich um eine neue Art von Workload: Agenten, die in eigener Verantwortung auf Produktivsysteme zugreifen. Gartner erwartet, dass fehlkonfigurierte KI in cyberphysischen Systemen bis 2028 die nationale kritische Infrastruktur in einem G20-Land lahmlegt.
Cyberkriminelle, die beruflich kritische Infrastruktur angreifen, haben gerade beobachtet, wie weit sich ein einzelner Ausfall ausbreiten kann. Die Verteidigung ist in beiden Fällen dieselbe: Eine Architektur, die sich von einem fehlerhaften Update erholen kann, muss sich auch von einem Angriff erholen können.
Daten für die Ausfallsicherheit verteilen
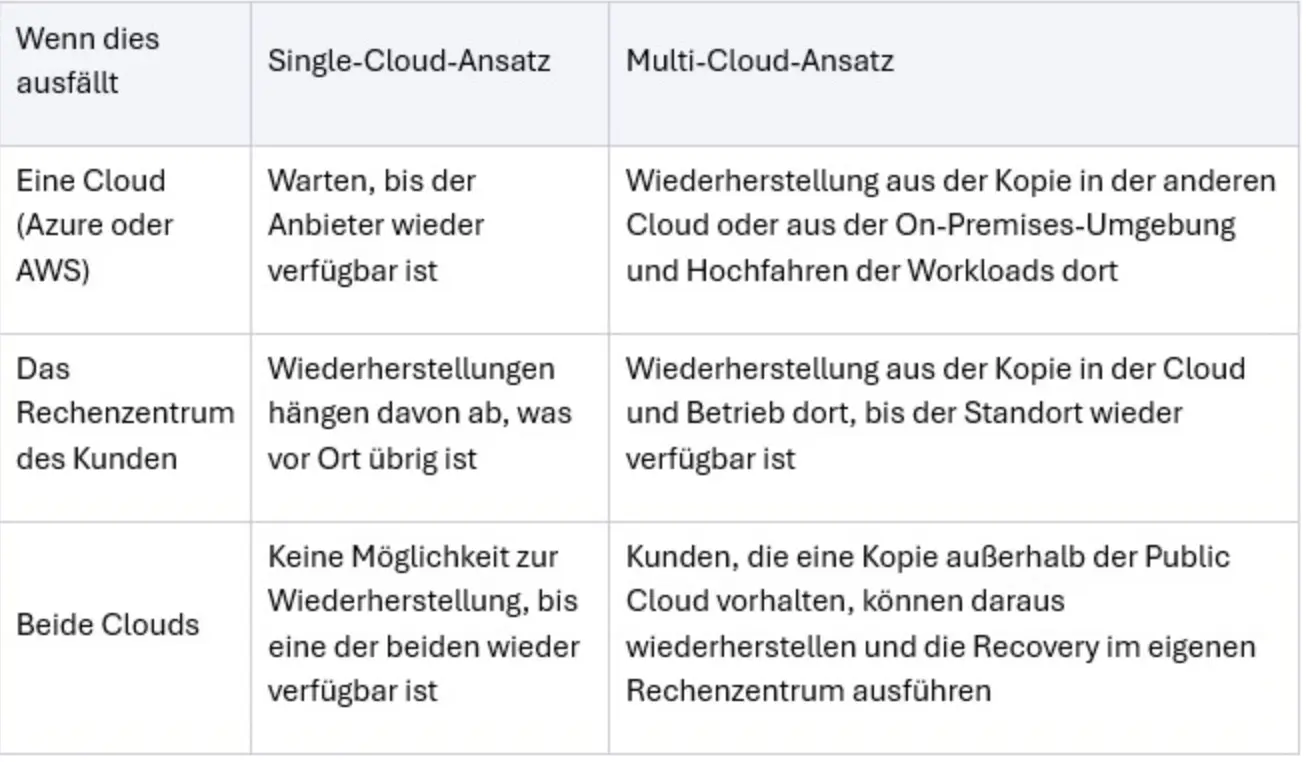
Darüber hinaus zeigen die Beispiele, wie wichtig es ist, Sicherung zu diversifizieren. IT-Teams müssen sich jetzt folgende Frage stellen: Wenn die primäre Cloud ausfällt: Woraus stellen wir wieder her, und wohin? Für viele Unternehmen lautet die ehrliche Antwort: „In dieselbe Cloud“. Daten, Backups und der Wiederherstellungspfad liegen alle bei einem einzigen Anbieter. Wenn dieser Anbieter ausfällt, bleibt nichts anderes übrig als zu warten.
Pranay Ahlawat, Chief Technology and AI Officer bei Commvault.
Wichtig sind daher Cloud-Lösungen, die so gebaut sind, dass es immer einen anderen Ort gibt, aus dem sich wiederherstellen lässt, und einen anderen, wohin sich wiederherstellen lässt: über Clouds hinweg, von On-Premises in die Cloud und von der Cloud zurück zu On-Premises.
Sicherheit durch Verteilung hat aber auch Nachteile: Jede zusätzliche Kopie kostet Geld, jede zusätzliche Umgebung erhöht die Komplexität. Die meisten Unternehmen, die sich als Multi-Cloud bezeichneten, betrieben in Wirklichkeit unterschiedliche Workloads in unterschiedlichen Clouds und echte Portabilität war selten und teuer. Das mag früher der richtige Ansatz gewesen sein.
Mittlerweile haben sich aber die Grundlagen verschoben. Workloads, die auf Containern und Kubernetes basieren, deren Infrastruktur als Code definiert ist und deren Daten von der darunterliegenden Plattform entkoppelt sind, lassen sich in einer zweiten Cloud oder in einem Rechenzentrum hochfahren, ohne neu gebaut zu werden. Nicht jeder Workload ist diesen Aufwand wert. Aber für die Handvoll Services, ohne die ein Unternehmen nicht arbeiten kann, ist Multi-Cloud-Resilienz heute besser erreichbar als je zuvor. Angesichts der aktuellen Ausfallereignisse lassen sich Folgekosten leichter als Argumente für diversifizierte Backups in Stellung bringen.
Drei Hausaufgaben für CISOs und Vorstände
Die neuen Ausfälle bringen die Notwendigkeit einer Inventur der IT-Infrastruktur auf die Agenda. Spätestens jetzt sollten sich alle wieder Gedanken machen, wo ihre kritischen Daten liegen und ob sie geschützt und gesichert sind. Die Transparenz aller Assets schafft dabei eine Grundlage für folgende Aufgaben:
- Herausfinden, was gemeinsam ausfällt: Unternehmen sollten ihre zehn wichtigsten Geschäftsservices definieren und für jeden die Abhängigkeiten von der Cloud bis hin zum Anbieter des jeweiligen Identitätsmanagements verfolgen, von denen er abhängt. Liegen Backups und dadurch geschützte Systeme in derselben Cloud? Lassen sich die Backups an einer anderen Stelle, einer anderen Cloud wiederherstellen? Entscheider müssen wissen, welcher Anbieterausfall was wie lange lahmlegt.
- Die Wiederherstellungszeit im echten Test messen: IT-Teams sollten festlegen, welche Services nach einem Tag wieder laufen müssen und welche Kosten jede Stunde Ausfall verursacht. Dann sollten sie unangekündigt einmal pro Quartal im Ernstfall – und nicht als geplante Übung – einen Anbieter ausfallen lassen und die Mean Time to Clean Recovery messen.
- KI-Agenten wie Produktionssysteme behandeln: KI ist mittlerweile für alle Firmen ein zentrales Asset. Unternehmen sollten daher auch ihre Agenten kennen. Sie müssen wissen, auf welche Daten sie zugreifen und was sie ändern können. Teams sollten mit einen Audit-Trail die Möglichkeit einfordern, sowohl den Agenten als auch alles, was er angefasst hat, zurückzurollen. Ohne eine Transparenz und die Möglichkeit des Zurückspulens darf ein Agent keine großen Aufgaben haben.
Vor dem nächsten Mal
Die Ereignisse der letzten Woche waren eine Generalprobe. Niemand wollte der IT bewusst schaden, und trotzdem haben die beiden Vorfälle Schäden in Milliardenhöhe verursacht. Beim nächsten Mal versucht es vielleicht jemand absichtlich, oder ein KI-Agent nimmt Änderung vor. Unternehmen sollten sich darauf vorbereiten und jetzt ein Konzept für kontinuierliche Wiederherstellung einrichten.
Übersicht: Große Ausfälle und Groundstops seit Juli 2024
Übersicht: Diversifizierung tut not


Neueste Kommentare
16. November 2026
16. November 2026
16. November 2026
3. November 2026
1. November 2026
21. Oktober 2026