(Auszug aus der Pressemitteilung)
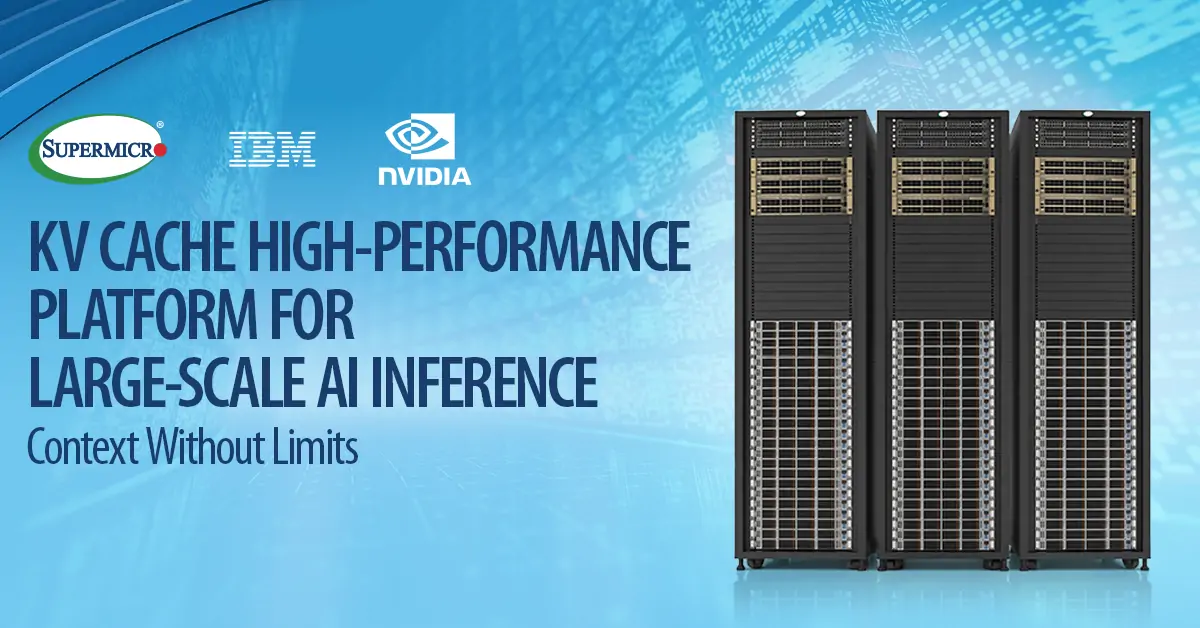
- Die KV-Cache-Lösung (Key-Value-Cache) vereint Supermicro Petascale-Storage-Server, die Software IBM Storage Scale, die Inferenzsoftware NVIDIA Dynamo sowie NVIDIA Spectrum-X-Ethernet-Switches
- Leistungstests zeigen, dass die KV-Cache-Lösung die Time-to-First-Token (TTFT) bei langen Kontextfenstern im Vergleich zu Systemen ohne KV-Cache verkürzt
- Kunden können die Effizienz der Inferenz durch eine höhere GPU-Auslastung, einen höheren Durchsatz und eine bessere Skalierbarkeit der Infrastruktur erheblich steigern
Super Micro Computer, Inc. (NASDAQ: SMCI), Total-IT-Solution-Anbieter für KI, Enterprise, Storage und 5G/Edge mit Data Center Building Block Solutions® (DCBBS), gab heute gemeinsam mit IBM und NVIDIA eine neue KV-Cache-Storage-Lösung bekannt. Die gemeinsame Lösung integriert Supermicro Petascale-All-Flash-Storage-Server mit Prozessoren der AMD EPYC 9005-Serie („Turin“), die Software IBM Storage Scale sowie die Inferenz-Framework-Software NVIDIA Dynamo und NVIDIA Spectrum-X-Ethernet-Netzwerktechnik.
Zusammen können diese Technologien die Zeit, die KI-Modelle benötigen, um mit der Generierung einer Antwort zu beginnen, drastisch verkürzen – ein entscheidender Vorteil, da Unternehmen zunehmend Agentic AI und KI-Workflows mit langem Kontext einsetzen. Die Erweiterung der KV-Cache-Kapazität über den lokalen GPU-Speicher hinaus kann die GPU-Auslastung und den Inferenzdurchsatz verbessern und gleichzeitig eine hohe Verfügbarkeit der KV-Cache-Inhalte sowie eine unterbrechungsfreie Skalierung der KV-Cache-Kapazität ermöglichen. Das Ergebnis ist eine skalierbarere, resilientere Inferenzarchitektur, die schnellere und reaktionsfähigere KI-Erlebnisse bietet.
„Da sich KI-Workloads vom Training auf die Inferenz ausweiten, müssen Unternehmen und Neoclouds Engpässe beseitigen, um die GPU-Effizienz zu verbessern – vor allem, wenn sie Inferenz-Workloads mit hohem Durchsatz betreiben, wie sie für Agentic AI und generative KI mit langem Kontext und mehreren Interaktionsrunden typisch sind“, sagte Charles Liang, President und CEO von Supermicro. „Unsere Lösung mit IBM und NVIDIA demonstriert diese Leistungsvorteile eindeutig.“
Inferenz-Workloads bestehen aus zwei Phasen: Prefill und Decode. Während des Prefill-Vorgangs wird der Eingabetext in Token umgewandelt und vom LLM verarbeitet, um die für die Inferenz erforderlichen Key-Value-Zwischenzustände (KV-Zustände) zu erzeugen. Durch die Speicherung dieser zuvor berechneten KV-Zustände in einem persistenten KV-Cache kann das System sie wiederverwenden, anstatt denselben Kontext für nachfolgende Anfragen neu zu berechnen. Agentic-AI-Workflows, Programmierassistenten, RAG mit langem Kontext, multimodale KI und Anwendungen mit mehreren Interaktionsrunden können bei der Verarbeitung umfangreicher Codebasen, Dokumente, Konversationen, Bilder und anderer Kontextdaten erhebliche Mengen an KV-Zuständen erzeugen. Dadurch wird die Kapazität des GPU- und CPU-Arbeitsspeichers schnell überschritten, und es entsteht die Notwendigkeit, den KV-Cache auf einen gemeinsam genutzten Netzwerk-Storage mit hoher Kapazität auszulagern.
Die KV-Cache-Lösung von Supermicro, IBM und NVIDIA stellt diese persistente Storage-Schicht bereit und trägt so zur Verbesserung der Inferenz-Effizienz, des Durchsatzes und der Skalierbarkeit bei, während redundante Berechnungen reduziert werden.
Zu den wichtigsten Vorteilen der KV-Cache-Lösung für Kunden zählen:
- Gemeinsame Lösungsvalidierung – Supermicro, IBM und NVIDIA führten umfangreiche Tests auf Cluster-Ebene durch, um die Leistung zu messen, darunter Szenarien mit hoher Parallelität und „Noisy-Neighbor“-Netzwerkverkehr.
- Deutlich schnellere und konsistentere Inferenzleistung – In gemeinsamen Tests von Supermicro und NVIDIA mit einem LLM mit 120 Milliarden Parametern lieferte der persistente KV-Cache bei Prompts mit 130.000 Token eine bis zu 56-mal kürzere TTFT.1 Bei einer Erhöhung der Eingabelänge von 30.000 auf 130.000 Token stieg die TTFT mit KV-Cache nur um 0,377 Sekunden, verglichen mit 29,55 Sekunden ohne KV-Cache, was eine konsistentere Leistung bei Workloads mit langem Kontext ermöglicht.
- Höhere GPU-Auslastung und höherer Durchsatz – Indem häufig wiederverwendete Kontexte außerhalb des GPU-Speichers verfügbar gehalten werden, trägt die Lösung dazu bei, die Leerlaufzeit der GPU zu reduzieren, den Inferenzdurchsatz zu steigern und eine höhere Parallelität zu unterstützen, ohne die GPU-Ressourcen proportional zu erhöhen.
- Resilienz auf Enterprise-Niveau und vertrauenswürdiger KI-Betrieb – Ein persistenter, hochverfügbarer KV-Cache trägt zum Schutz des zwischengespeicherten Inferenzzustands bei und ermöglicht gleichzeitig den gemeinsamen Zugriff über GPU-Knoten und Cluster hinweg, wodurch resilientere und Storage-effizientere KI-Dienste in großem Maßstab unterstützt werden.
- Validierte, schlüsselfertige KI-Infrastruktur – Supermicro, IBM und NVIDIA haben die integrierte Architektur gemeinsam in Szenarien mit hoher Parallelität und „Noisy-Neighbor“-Bedingungen validiert, wobei NVIDIA Dynamo, die Software IBM Storage Scale, Supermicro Petascale-Server sowie NVIDIA Spectrum-X-Netzwerktechnik kombiniert wurden.
- Beschleunigte Bereitstellungsdienste – Die werkseitige Rack-Integration und die Vor-Ort-Bereitstellungsdienste von Supermicro können die Bereitstellungszeit dieser Lösung von Wochen auf Tage verkürzen.
„Unternehmen benötigen einen grundlegend besseren Ansatz zur Skalierung der KI-Inferenz. Gemeinsam bieten IBM, Supermicro und NVIDIA eine leistungsstarke, ausfallsichere KV-Cache-Lösung an, die Kunden dabei unterstützt, ihre GPU-Investitionen zu maximieren, unabhängig von den Rechenressourcen zu skalieren und die Effizienz ihrer Infrastruktur erheblich zu verbessern“, sagte Sam Werner, General Manager IBM Storage. „Diese Zusammenarbeit stellt einen wichtigen Schritt dar, um die KI-Inferenz in Unternehmen skalierbarer, zuverlässiger und kosteneffizienter zu gestalten.“
„Agentic AI und Anwendungen mit langem Kontext sind darauf angewiesen, den Kontext über viele Schritte hinweg effizient wiederzuverwenden, und NVIDIA Dynamo unterstützt die Orchestrierung verteilter Inferenz, sodass Unternehmen aus jeder GPU einen höheren nutzbaren Durchsatz erzielen können“, sagte Shruti Koparkar, NVIDIA AI Inference Product Lead. „Durch die Kombination von NVIDIA Dynamo und Spectrum-X Ethernet mit den Supermicro Petascale-Storage-Servern und IBM Storage Scale schafft diese KV-Cache-Lösung eine leistungsstarke, gemeinsam genutzte Storage-Ebene, die redundante Rechenvorgänge reduzieren, die Time-to-First-Token verkürzen und Kunden dabei unterstützen kann, ausfallsichere KI-Inferenzdienste zu skalieren.“
1 Detaillierte Ergebnisse im IBM Redbook: https://www.redbooks.ibm.com/docs/MD260021/MD260021.html



Neueste Kommentare
6. November 2026
3. November 2026
1. November 2026
21. Oktober 2026
21. Oktober 2026
18. Oktober 2026